
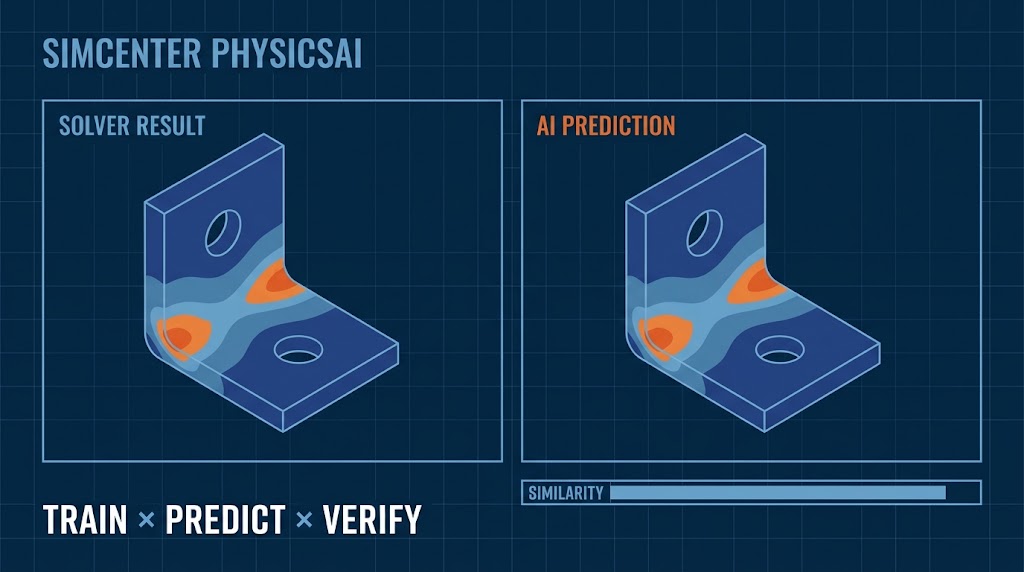
一次高保真的结构或流体仿真,往往需要数小时甚至更长时间。设计方案一多,仿真资源就成了瓶颈:能算的方案有限,很多设计变体只能凭经验取舍。AI 预测模型提供了另一种思路:用已有的仿真结果训练模型,对新方案在很短时间内给出预测,让工程师在同样的时间里评估更多方案。
但 AI 模型并不是对所有任务都适用。它的可信度取决于训练数据覆盖了什么,而不是软件本身有多先进。同一个工具,用在合适的任务上能显著加快设计迭代,用错了地方则可能给出看似合理、实则偏离的结果。本文以 Simcenter PhysicsAI 为例,从数据、设计变化范围、预测对象、精度要求和使用环节五个方面,梳理如何判断一项预测任务是否适合交给 AI 模型。
- PhysicsAI 的预测能力来自求解器结果,它补充求解器,而不是替代求解器;
- 训练数据要同类、足量、一致,数据整理对精度的影响往往大于调整训练参数;
- 新设计超出训练数据覆盖范围时可信度下降,应结合相似度评分和测试误差判断;
- 预测结果适合用于方案探索和筛选,最终验证、强度签字和认证计算仍以求解器为准。
一、Simcenter PhysicsAI 是什么、怎么工作
Simcenter PhysicsAI 是一款基于几何深度学习的预测建模工具。它用已有的仿真结果作为训练数据,学习几何形状与物理响应之间的关系,再对新的几何方案直接给出预测。目前它集成在 Simcenter Hypermesh、Simcenter Inspire 和 Simcenter Simlab 中,也可作为 Simcenter STAR-CCM+ 的附加模块使用。与传统代理模型相比,它有几个不同之处:
直接学习网格
传统代理模型通常需要先把设计参数化,用若干个尺寸变量描述几何;PhysicsAI 直接以网格为输入,不要求事先参数化,因此能处理形状甚至拓扑不同的设计。
可预测完整云图
除了最大应力、压降等标量指标,还可以预测整个模型上的应力、压力、温度等场结果,看到问题出现在哪里。
与求解器无关
训练数据可以来自 OptiStruct、Nastran、Radioss、STAR-CCM+ 等不同求解器的结果,企业已有的仿真数据都可以作为训练来源。
使用流程一般分为五步:建立项目、构建数据集、训练模型、测试模型、对新方案进行预测。构建数据集时,需要选择输入特征(如坐标、部件标签、厚度、材料)和输出响应(场结果、标量指标或曲线)。
PhysicsAI 补充求解器,而不是替代求解器。
它的预测能力完全来自求解器结果,高保真仿真仍是验证的基准。它的价值在于让工程师用更少的求解器计算评估更多方案,把计算资源留给最值得深入分析的设计。
二、数据:是否有足够且一致的历史仿真数据
AI 模型的能力上限由训练数据决定。判断一项任务是否适合,首先要看手上的数据:
数据是否同类
训练样本应属于同一类产品、同一类分析,且关注的物理问题一致。用一批支架的静力分析结果,无法训练出预测壳体模态的模型。
数据是否足量
样本需要能够代表设计可能变化的范围。数量没有统一下限,取决于几何变化的复杂程度;变化越多样,需要的样本越多。
数据是否一致
没有作为输入特征的设置,如载荷工况、边界条件、网格密度和结果输出方式,应尽量统一;需要预测其影响的参数,如载荷大小或材料,则应作为输入特征明确定义。设置不一致又未加区分的样本混在一起,模型学到的是噪声,而不是规律。
如果企业已经积累了大量同类产品的仿真结果,这类任务的起步条件最好;如果历史数据很少,就需要先规划一批仿真来生成训练数据,此时要把这部分计算成本计入判断。总体来看,只有同类任务反复出现、需要评估的方案足够多时,生成数据和训练模型的投入才能被大量快速预测摊薄;一次性的分析,或只需比较少数几个方案时,直接用求解器计算往往更省事。
三、范围:新设计是否在训练数据覆盖范围内
AI 模型擅长在训练数据覆盖的范围内做预测,超出这个范围,可信度就会下降。需要从三个方面确认新设计是否落在覆盖范围内:
| 维度 | 在覆盖范围内 | 超出覆盖范围 |
|---|---|---|
| 几何 | 形状变化属于训练样本中出现过的类型,如尺寸、开孔位置、筋板布置的变化 | 出现训练样本中没有的结构形式或特征 |
| 工况与边界 | 载荷大小、材料等作为输入特征的参数,取值在训练数据的变化范围内;载荷类型和约束方式与训练样本一致 | 参数取值超出训练范围,或出现训练数据中没有的载荷类型、约束方式 |
| 物理问题 | 与训练数据属于同一物理领域和流动、受力状态 | 跨物理问题使用,例如用外流场数据训练的模型去预测内流问题 |
需要说明的是,PhysicsAI 除了几何,还可以把材料属性、边界条件等非几何参数作为输入特征。只要这些参数在训练数据中有足够的变化,模型就能在该范围内预测它们的影响;而训练数据中从未变化过的参数,模型无法学到它的影响。
判断是否超出范围,不能只凭经验。PhysicsAI 会为每个预测给出相似度评分(Similarity Score):取值在 0 到 1 之间,越接近 1,说明新设计与训练样本越接近。2026.1 版本还会针对厚度等连续输入分别给出评分,可以看出设计的哪些方面被训练数据覆盖得好、哪些方面覆盖不足。
相似度评分低的方案,预测结果只能作为参考,应安排求解器计算确认;如果这类方案经常出现,说明训练数据需要补充,可以把新的求解器结果加入数据集,重新训练模型。
四、对象:要预测的是什么
同样是“预测”,要预测的对象不同,对模型和数据的要求也不同:
- 标量指标与曲线:如最大位移、压降、阻力系数、力—位移曲线,适合用于方案排序和快速筛选。
- 场结果(云图):如应力、压力、温度分布,能显示问题发生的位置,适合需要判断薄弱区域、优化局部结构的任务。
- 局部峰值与热点:如应力集中处的最大值,往往是设计判断最关注的数值,但它取决于局部几何和网格细节,评估模型时应单独核对峰值区域的预测效果,而不能只看整体误差。
PhysicsAI 提供了几种不同的模型架构,可以按预测对象选择:
| 模型架构 | 特点 | 适用对象 |
|---|---|---|
| GCNS(Graph Context Neural Simulator) | 默认架构,内存需求较低 | 场结果、标量指标、曲线 |
| TNS(Transformer Neural Simulator) | 不依赖特定网格,GPU 上速度更快,更适合瞬态结果 | 碰撞、跌落等瞬态问题的场结果 |
| SER(Shape Encoding Regressor) | 速度最快,只输出标量指标和曲线 | 早期方案的快速筛选 |
如果任务只需要比较几个关键指标的高低,标量预测就足够;如果需要知道“哪里不行”,就应选择能输出云图的架构,并准备包含完整场结果的训练数据。
五、精度:误差边界如何评估
一项任务能否交给 AI 模型,要看模型的误差是否在任务可以接受的范围内。这个判断不能依据厂商宣传的精度数字,而要用自己的数据评估:
- 预留测试样本数据集按比例分为训练集和测试集,测试样本不参与训练,只用来检验预测效果。测试样本应覆盖实际要预测的设计范围;同时要避免训练集和测试集中出现几乎相同的样本,例如同一设计仅有微小尺寸差异,否则测试误差会被低估。
- 查看误差指标和训练曲线关注测试集上的平均绝对误差,以及训练集和测试集上的损失曲线是否收敛、是否出现过拟合。
- 与求解器结果逐项对比抽取若干测试样本,把预测云图和关键指标与求解器结果叠加比较,重点检查最大值的大小和位置。
- 结合任务定义可接受误差用于方案排序时,只要预测能正确区分方案优劣即可;用于判断是否满足设计限值时,误差必须明显小于设计余量。
还要注意,测试集上的误差只代表与训练数据相近的设计。对新方案的可信度,还需要结合前文介绍的相似度评分一起看:测试误差小、相似度高的预测,才可以作为方案筛选和比较的依据。
建议在正式训练前,先用一小部分数据和默认参数跑通一次完整流程,确认数据、特征和输出设置正确,再扩大到全部数据,避免在设置错误的数据上浪费训练时间。
六、环节:预测结果用在哪个决策环节
同样的预测精度,放在不同的决策环节,风险完全不同。按照在设计流程中的位置,可以大致分为三类:
适合直接使用
早期方案探索和多方案筛选、优化循环中替代部分求解器计算、设计评审前快速评估多个变体。这些环节需要的是“快”和“方向正确”,个别预测偏差可以通过后续仿真纠正。
需要配合求解器使用
方案收敛阶段的设计调整。可以先用预测结果缩小范围,再对候选方案做求解器计算确认。
不应直接使用
最终设计验证、强度校核签字、认证和法规要求的计算。这些环节需要的是可追溯的高保真结果,应以求解器计算为准。
如果这个预测错了,后面有没有环节能发现并纠正?
这是一个实用的判断方法。如果有,比如筛选出的候选方案还要再做仿真,那么 AI 预测的风险是可控的;如果没有,预测结果会直接进入最终决策,就不应该只依靠 AI 模型。
七、适用性判断清单
把以上五个方面,连同投入产出,整理成一张清单,评估一项预测任务时可以逐项核对:
| 判断项 | 适合交给 AI 模型 | 需要谨慎或暂不适合 |
|---|---|---|
| 历史数据 | 有一批同类产品、同类分析、设置一致的仿真结果 | 数据很少,或工况、边界、网格设置差异大 |
| 设计变化 | 新方案的形状、工况都在训练样本覆盖范围内,相似度评分高 | 出现新的结构形式、载荷类型或物理问题 |
| 预测对象 | 标量指标、曲线或整体场分布 | 只关心对局部细节高度敏感的峰值,且未经单独验证 |
| 精度要求 | 测试集误差明显小于任务可接受的误差 | 误差与设计余量处于同一量级 |
| 使用环节 | 方案探索、筛选、优化循环,后续还有仿真确认 | 最终验证、强度签字、认证计算 |
| 投入产出 | 同类任务反复出现,需要评估大量方案 | 一次性分析,或只需比较少数几个方案 |
各项都落在左栏,说明这项任务具备较好的适用条件;只要有一项落在右栏,就应先解决这一项的问题,或把 AI 预测限定在辅助参考的位置。
八、从试点到应用的推进建议
引入 AI 预测,宜从一个边界清楚的任务开始,逐步积累信心:
- 选一个合适的试点任务选择同类设计反复出现、历史仿真数据较多、预测结果用于方案筛选的任务,按上面的清单逐项确认
- 整理数据集统一工况、边界和输出设置,剔除离群和不一致的样本,明确输入特征和输出响应
- 训练并评估模型预留测试样本,用误差指标、损失曲线和与求解器结果的对比评估精度,并确定这项任务的可接受误差
- 在实际项目中并行验证在一段时间内,对 AI 筛选出的候选方案同时做求解器计算,持续比对,确认模型在真实设计中的表现
- 建立更新机制把新产生的求解器结果补充进数据集,定期重新训练;相似度评分持续偏低时,及时补充训练样本
这类工具的定位是让仿真工程师直接使用,而不是交给单独的数据团队。工程师对产品、工况和结果的理解,是判断数据是否合理、预测是否可信的关键。
九、常见误区
- 误区一:有了 AI 模型就不需要求解器。AI 模型的预测能力来自求解器结果,训练数据要靠仿真生成,关键方案的最终结论也要由求解器确认。
- 误区二:数据越多越好。数据的一致性和代表性比数量更重要,设置不一致的样本和离群样本会降低模型精度,训练前需要先整理。
- 误区三:测试精度高,就可以预测任何新设计。测试误差只代表与训练数据相近的设计,新方案超出覆盖范围时,可信度会下降,需要结合相似度评分判断。
- 误区四:整体误差小,关键位置就一定准。整体平均误差可能掩盖局部峰值的偏差,涉及应力集中等关键数值时应单独核对。
- 误区五:模型训练一次就能长期使用。产品设计、材料和工况会变化,模型需要随新的仿真数据持续更新。
十、结语
判断 PhysicsAI 适合什么预测任务,核心是回答三个问题:训练数据能否代表要预测的设计,模型误差能否满足任务要求,以及预测结果错了之后有没有环节可以纠正。满足这三个条件的任务,AI 预测能够显著扩大方案探索的范围;不满足的任务,求解器仍然是可靠的选择。把 AI 预测放在合适的位置,与高保真仿真分工配合,才能既提高效率,又守住工程判断的可信度。
Simcenter PhysicsAI 的功能与应用场景可参考 Simcenter PhysicsAI 产品页。如需结合企业已有仿真数据评估 AI 预测的可行性、开展试点,也可以了解我们的 工程仿真与物理测试 服务。